
تعاني النماذج اللغوية الكبيرة مثل GPT وClaude من ضعف واضح عند التعامل مع اللغات ذات الموارد الرقمية المحدودة، وتحديداً اللغة الأمازيغية المكتوبة بحرف تيفيناغ. لسد هذه الفجوة التقنية، أطلق مهندس البرمجيات المغربي رشيد نيشان مشروع نموذج الذكاء الاصطناعي الأمازيغي Awal-LM، وهو نظام مفتوح المصدر مصمم لفهم وتوليد النصوص الأمازيغية مباشرة بحروفها الأصلية. يستعرض هذا المقال البنية التقنية للمشروع، المراحل البرمجية التي مر بها من لغة C++ إلى معمارية Gemma-2، وكيفية مساهمة المعهد الملكي للثقافة الأمازيغية (IRCAM) في هيكلة بياناته، إلى جانب طرق تجربة النموذج أو المساهمة في تطويره.
ما هو نموذج الذكاء الاصطناعي الأمازيغي Awal-LM؟
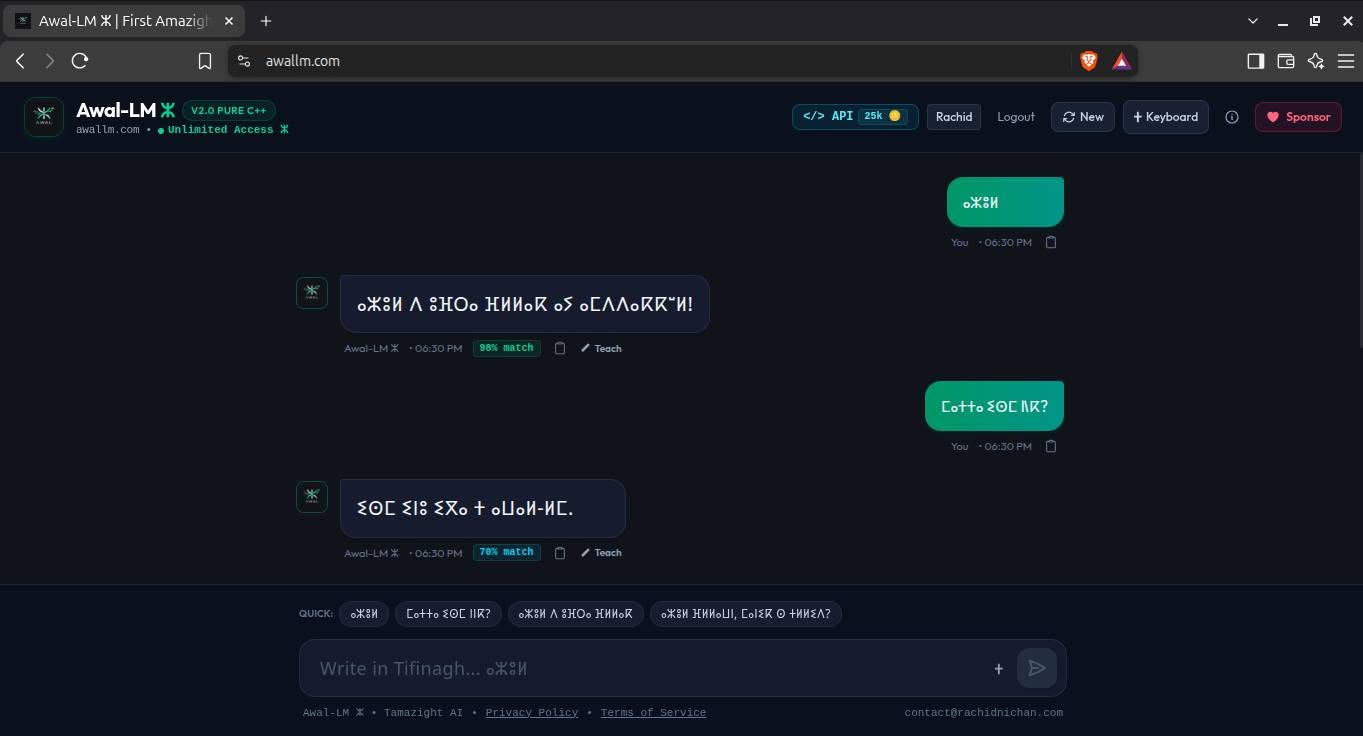
أطلق المهندس رشيد نيشان، المقيم في الدار البيضاء والمنحدر من منطقة تافراوت بسوس، منصة Awal-LM (كلمة “أوال” تعني الكلام أو الحديث بالأمازيغية) كأول محرك لغوي عصبي مخصص بالكامل للغة الأمازيغية المعيارية. يهدف المشروع إلى تمكين المستخدمين من إجراء محادثات نصية، طرح أسئلة، وتنفيذ أوامر برمجية بسيطة باستخدام أبجدية تيفيناغ (Neo-Tifinagh) دون الحاجة إلى الكتابة بالحرف اللاتيني أو العربي كوسيط.
يتوفر المشروع بنسخة تجريبية مباشرة عبر الويب (awallm.com)، كما طرح المطور الشفرة المصدرية والأوزان البرمجية عبر منصتي GitHub وHugging Face لإتاحة المجال أمام المبرمجين والباحثين اللسانيين لاختباره وبناء تطبيقات تعتمد على واجهة برمجة التطبيقات (API) الخاصة به.
التحدي التقني : لماذا تفشل النماذج العالمية مع أبجدية تيفيناغ؟
تتعامل النماذج اللغوية التجارية مع النصوص عبر تقسيمها إلى وحدات صغيرة تُعرف بالرموز أو التوكنز (Tokens). صُممت هذه المقسمات النصية (Tokenizers) بناءً على لغات مهيمنة في الإنترنت مثل الإنجليزية والفرنسية. عند إدخال نص مكتوب بحرف تيفيناغ في نموذج تقليدي، يفشل المقسم في التعرف على الكلمات كوحدات ذات معنى، فيقوم بتفتيتها إلى وحدات بايت (UTF-8 Bytes) منفصلة وعشوائية.
يؤدي هذا التفتيت إلى مشكلتين تقنيتين:
- استهلاك مضاعف للذاكرة الحاسوبية : الكلمة الأمازيغية الواحدة قد تستهلك ما بين 10 إلى 15 رمزاً (Token)، مما يبطئ سرعة الاستجابة ويرفع تكلفة المعالجة.
- فقدان السياق الدلالي : بسبب تشتت الحروف، يعجز النموذج عن ربط الجذور اللغوية الأمازيغية وتصريفات الأفعال ببعضها، مما ينتج إجابات غير مفهومة أو هلوسات نصية.
البنية البرمجية : من محرك C++ المستقل إلى معمارية Gemma-2
مر تطوير نموذج الذكاء الاصطناعي الأمازيغي Awal-LM بمسارين تقنيين مختلفين للتغلب على معضلة المعالجة اللغوية وضعف الموارد الحسابية، حيث بدأ المطور العمل على حاسوبه الشخصي المعتمد على نظام Arch Linux دون الاستعانة بعناقيد خوادم البطاقات الرسومية (GPUs) المكلفة.
1. المحرك العصبي الخفيف بلغة C++17 (الإصدارات 2.1 و 2.2)
في هذا المسار، بنى رشيد نيشان محركاً لغوياً من الصفر باستخدام لغة C++17 الصرفة، مستغنياً عن مكتبات بايثون الثقيلة مثل PyTorch أو TensorFlow. أثمر هذا التوجه الهندسي عن خصائص تقنية محددة:
- حجم ذاكرة مصغر : يعمل المحرك كملف تنفيذي (Binary) لا يتجاوز استهلاكه للذاكرة العشوائية 1.3 ميغابايت (أقل من 2 ميغابايت في أقصى حالات التشغيل).
- زمن استجابة فائق السرعة : يعالج المحرك الاستفسارات عبر المعالج المركزي (CPU) في أقل من 5 أجزاء من الألف من الثانية (Sub-5ms Latency).
- مقسم نصوص مخصص (Native IRCAM Tokenizer) : يتعرف بشكل أصلي على حروف تيفيناغ الـ 33 المعتمدة رسمياً، مع الحفاظ على علامات الترقيم الخاصة دون تكسير الكلمات.
- التحليل الصرفي والدلالي : يدمج النظام تقنيات (N-Grams) للأحرف مع متجهات دلالية من 96 بُعداً (96-Dimensional Cosine Vectors)، مدعومة بمحرك تصريف أفعال يغطي الأزمنة الثلاثة (الماضي، المضارع، والأمر) لجميع الضمائر الأمازيغية التسعة.
2. نموذج التوليد اللغوي المبني على Gemma-2 (الإصدار v1.8)
لتوسيع قدرات التوليد النصي الحر والإجابة على الأسئلة المعقدة، اعتمد الإصدار v1.8 مقاربة مختلفة ترتكز على نموذج Gemma-2-2B مفتوح المصدر من شركة جوجل (يضم ملياري مُعامل).
قام المطور بإعادة ضبط هذا النموذج (Fine-Tuning) باستخدام أداة Unsloth وتقنية محولات LoRA (Low-Rank Adaptation)، وهي طريقة تسمح بتدريب النموذج على لغة جديدة بكفاءة عالية دون الحاجة لإعادة تدريب كافة أوزانه الأصلية.
دور معايير المعهد الملكي للثقافة الأمازيغية (IRCAM) في تدريب النموذج
لا يمكن لأي نموذج ذكاء اصطناعي أن يتقن لغة ما دون قاعدة بيانات (Dataset) منظمة ونقية. اعتمد تدريب Awal-LM بشكل مباشر على المعايير الأكاديمية واللسانية التي أرساها المعهد الملكي للثقافة الأمازيغية (IRCAM) في المغرب.
شملت البيانات المستخدمة في التدريب:
- الأبجدية الرسمية المكونة من 33 حرفاً بتيفيناغ المعياري.
- قواميس ومعاجم ثلاثية اللغات (أمازيغية – عربية – فرنسية) لتعزيز الفهم الدلالي للمفردات.
- نصوص أدبية، قواعد نحوية، وأزواج من التعليمات البرمجية والأسئلة والأجوبة المصاغة يدوياً لتعليم النموذج كيفية اتباع الأوامر (Instruction Tuning).
مشروع تشاركي مفتوح للمطورين والباحثين اللسانيين
يصنف رشيد نيشان نموذج Awal-LM حالياً كمشروع تجريبي قيد التطوير المستمر. ولضمان دقة المخرجات اللغوية وتفادي الأخطاء النحوية، تتضمن المنصة آلية “التعلم المعزز من التغذية الراجعة البشرية” (RLHF) عبر نافذة تفاعلية (Teach Loop). تتيح هذه الميزة للناطقين بالأمازيغية والخبراء اللغويين اقتراح تصحيحات مباشرة أو إضافة ثنائيات حوارية جديدة، حيث تُراجع هذه المساهمات قبل دمجها في دورات التدريب اللاحقة للمحرك.
يفتح المشروع الباب أمام المبرمجين المغاربة والمهتمين باللسانيات الحاسوبية للمساهمة في ثلاث واجهات: توسيع قاعدة البيانات النصية على Hugging Face، تقييم ردود النموذج وتصحيحها عبر المنصة المباشرة، أو استخدام واجهة API الخاصة بـ Awal-LM لبناء أدوات ترجمة، تطبيقات تعليمية، ومساعدات رقمية تدعم الأمازيغية في الإدارات والخدمات الإلكترونية.